アンケートの自由記述をAIで分類するときは、分類名だけでなく、どの回答にどのラベルを付けたかを原文と照合します。ひとつの回答に複数の話題が含まれるなら、複数ラベルを付ける設計もできます。その場合、回答した人の数とラベルを付けた回数は一致しません。集計表でこの二つを分けて示し、AIの分類を確定結果として扱う前に人が確認してください。
分類の前に単位とラベルを決める
自由記述を分類する前に、何を一件として数えるかを決めます。回答者一人につき一つの回答欄があるのか、一人が複数の回答を送れるのか、空欄を回答数に含めるのかで、集計の単位は変わります。回答者数、回答行数、実際に分類した回答数を同じものとして扱わないようにしてください。集計表には、どの単位の数かを明記します。
次に、分類ラベルの意味を短く定義します。たとえば「価格」は料金・費用に触れた記述、「使いやすさ」は操作・画面の分かりやすさに触れた記述、といった基準を決めます。肯定と否定を分けて集計するなら、その方向も分類基準に含めます。「価格が高い」と「操作が分かりやすい」は、一つの回答の中に同時にあっても矛盾しません。ラベルを一つだけ選ぶのか、複数を付けてよいのかも、集計前に明示してください。
分類の意味が似ていたり、対象範囲が重なったりすると、同じ回答に違うラベルが付くことがあります。試しに少量の回答へ基準を当て、判断に迷った文を記録します。基準を変えた場合は、変更前に分類した回答にも新しい基準を適用し直す必要があるかを検討します。分類名を増やすことが目的ではなく、後から見た人が同じ判断をたどれることが大切です。
回答に氏名、連絡先、自由記述から個人を推測できる情報、社内情報が含まれることがあります。社内のルールと利用するAIサービスの入力可否を確認し、承認なしに個人情報や機密情報を外部AIへ送らないでください。匿名化やID付与をする場合も、再識別につながる情報が残っていないかを確認します。
少量の回答で分類基準を試す
最初から全件に分類をかけず、まず少量の回答でラベルの定義と出力形式を試します。各回答を一つの行にし、回答ID、原文、付与したラベル、根拠となる語句、判断保留の有無を分けて記録します。回答IDは個人を示さない管理用の記号にし、本文の語句を根拠として残すことで、ラベルだけから理由を推測するのを避けられます。
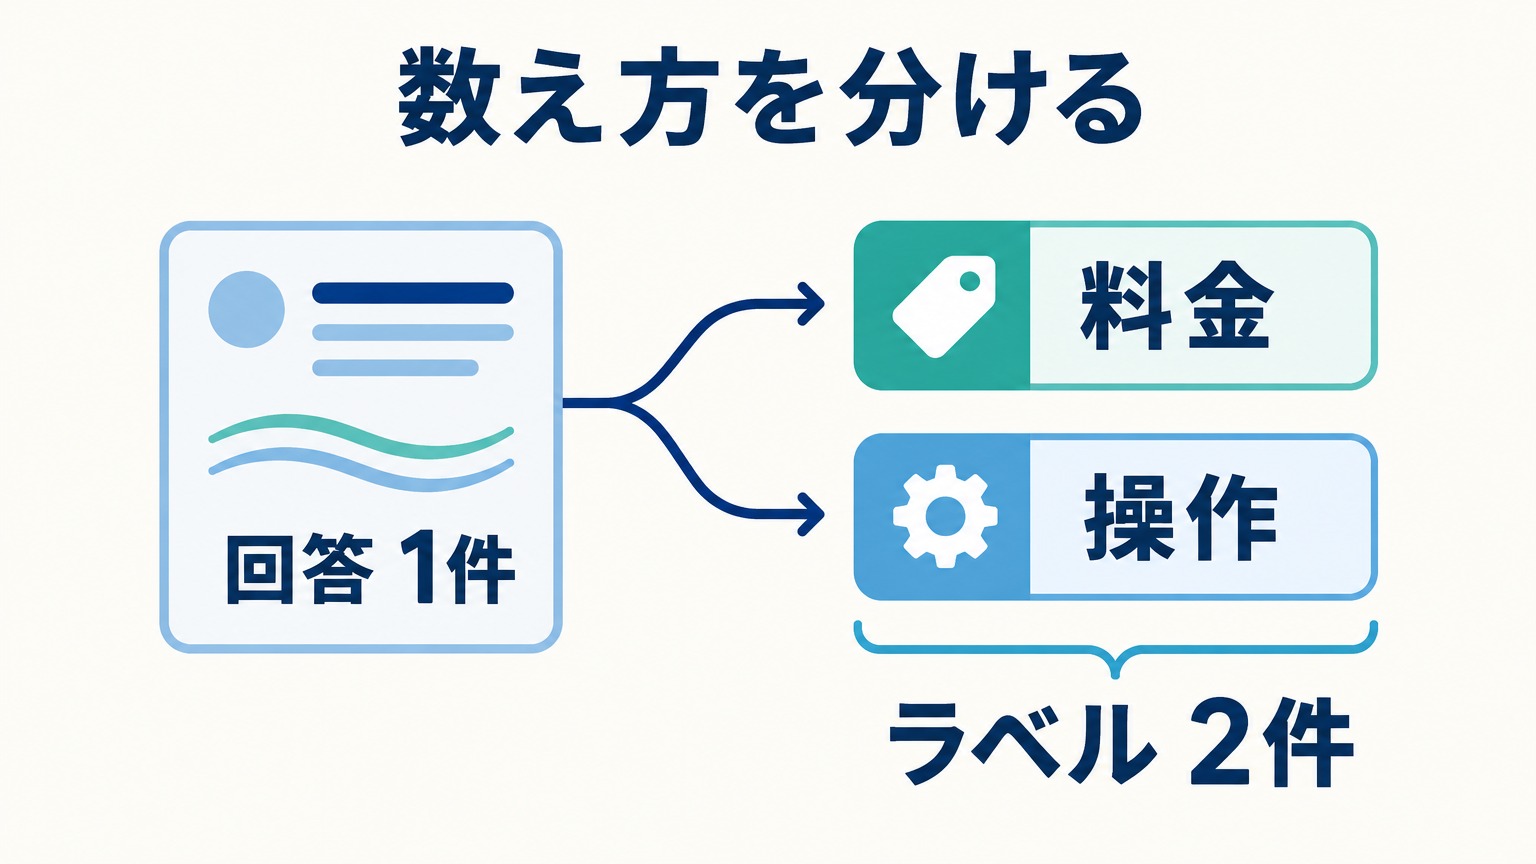
複数ラベルを許す場合は、複数の話題を含む回答をどう扱うかを先に決めます。たとえば一つの回答に料金と操作の話があれば、両方のラベルを付ける方法があります。一方、単に二つの単語が並んでいるだけで、話題との関係が読み取れない場合は、ラベルを無理に付けず「判断保留」とします。AIが文脈を補って意味を決めたように見えても、回答者が書いていない意図を推測で加えてはいけません。
少量の試行では、分類基準に当てはまらない回答や、複数に読める回答も確認します。分類できない記述をすべて「その他」に押し込めると、ラベルの範囲が曖昧になります。「その他」に含める条件と、保留にする条件を分けて決めます。基準を修正した場合は、その変更内容と適用範囲を残し、試行データだけに当てた基準が全体でも使えるかを確認してから本作業へ進みます。
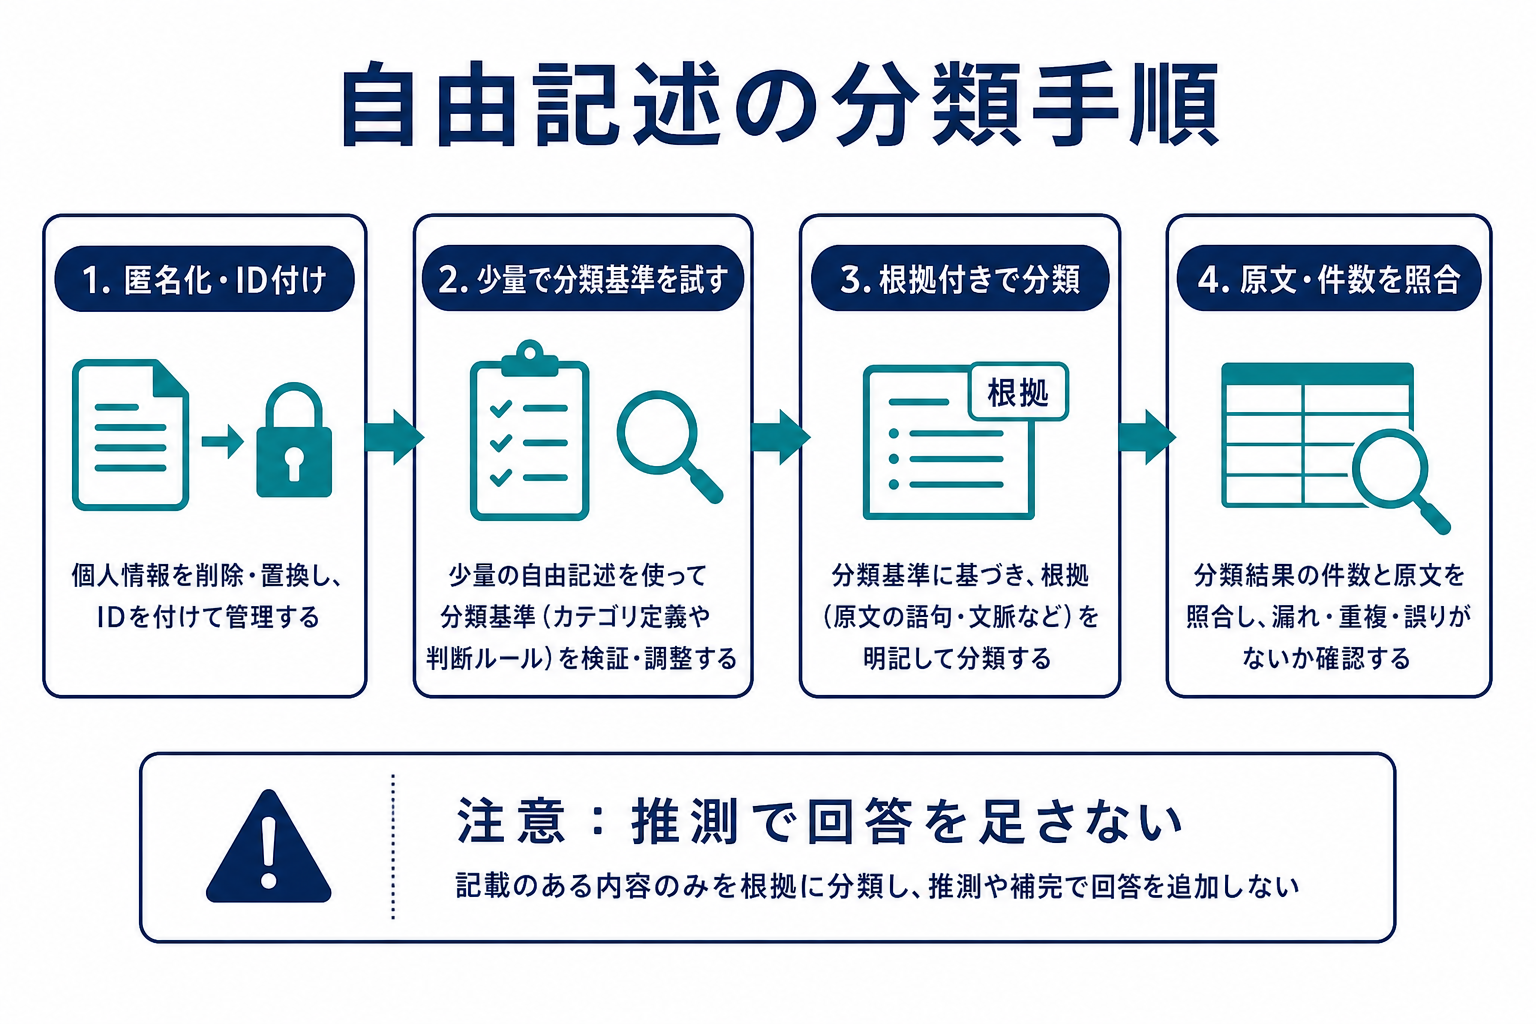
作業の流れは、回答の匿名化とID付与、少量で基準を試すこと、根拠付きの分類、原文と件数の照合です。
回答を準備する。入力してよい回答だけを使い、回答IDと元の文章を対応させます。
分類基準を決める。ラベルの意味、複数付与、空欄や対象外の扱いを先に決めます。
ラベルの根拠を確認する。AIの分類候補を原文に戻って確かめ、判断できないものは保留します。
件数を分けて数える。回答数とラベル付与件数を混同せず、複数ラベルの数え方を残します。
補足の図を開く(手順と数値は本文でも確認できます)
回答IDを使うと、同じ回答が重複していないか、分類結果と原文が対応しているかを確認できます。IDは回答を追うためのものとし、個人の氏名やメールアドレスを含めないようにします。匿名化したデータと対応表を別に管理する場合も、その保管方法が社内ルールに沿っているかを確認してください。
架空の回答A・Bを分類する
次の回答は、分類方法を説明するための架空例です。実際の調査結果や特定のサービスに対する評価ではありません。分類ラベルは「価格」と「使いやすさ」の二つとし、一つの回答に複数のラベルを付けてよいものとします。
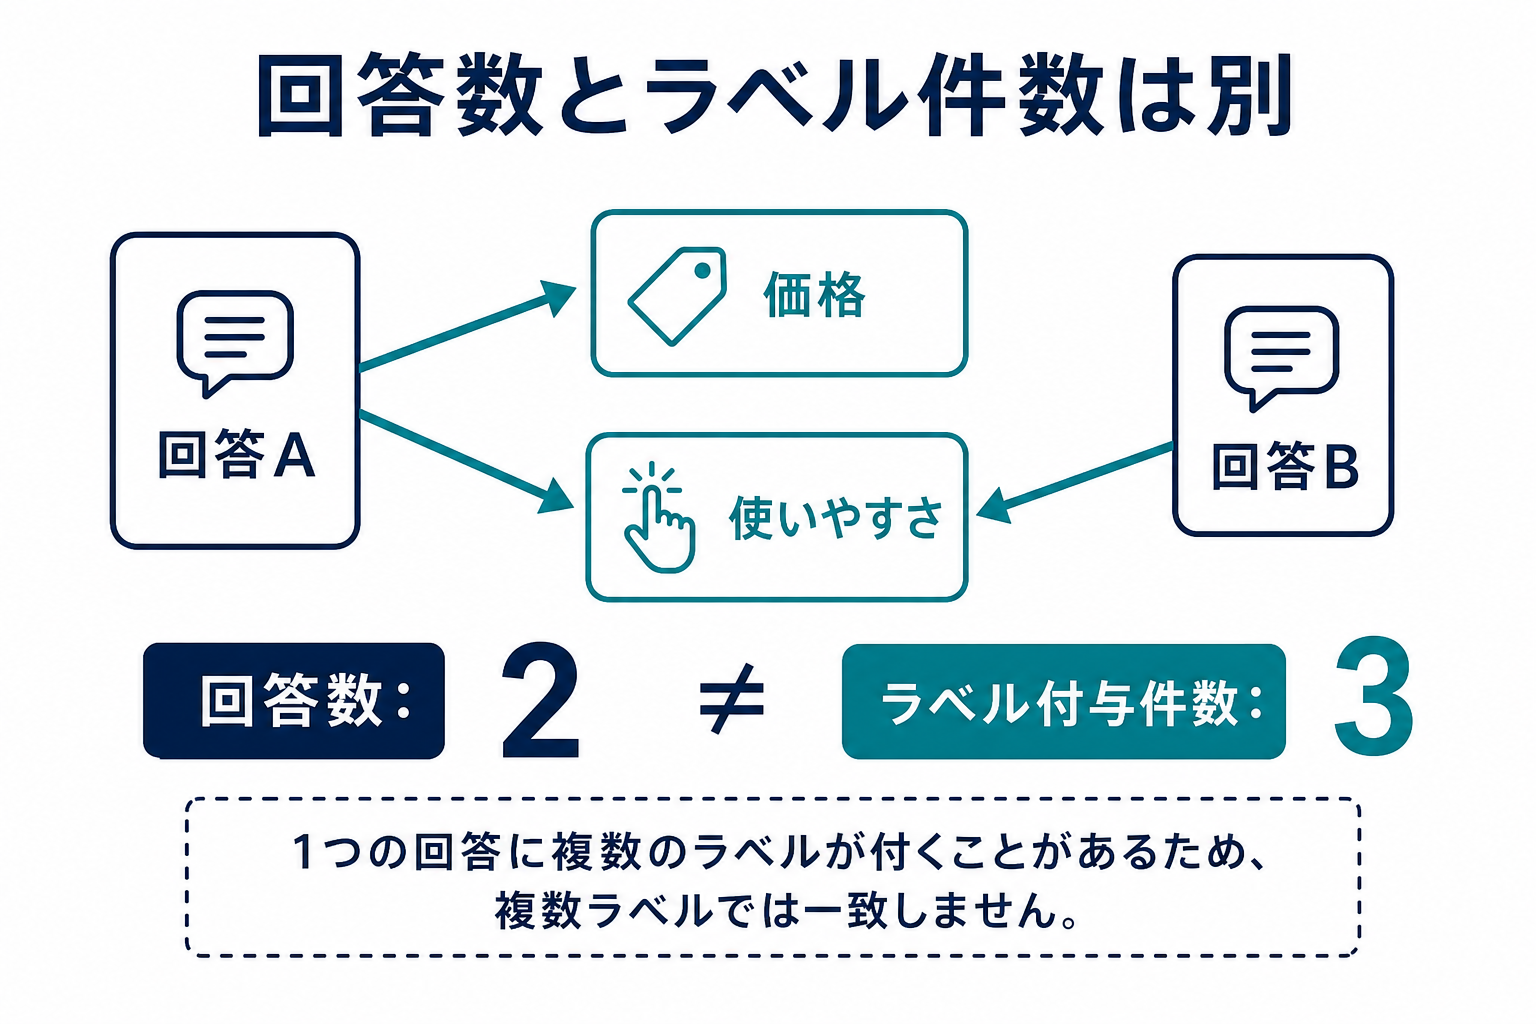
回答A:「料金が少し高く感じます。画面の操作は分かりやすかったです。」
回答B:「メニューを探すのに迷いました。」
この基準では、回答Aに「価格」と「使いやすさ」の二つ、回答Bに「使いやすさ」を付けます。回答Aの「料金が少し高く感じます」は価格の根拠で、「画面の操作は分かりやすかったです」は使いやすさの根拠です。回答Bの「メニューを探すのに迷いました」は、操作の分かりにくさを示す使いやすさの根拠です。肯定・否定の方向を別に記録する場合は、ラベルと感想の方向を別欄にします。
| 回答ID | ラベル | 根拠となる原文 | 方向の例 |
|---|---|---|---|
| A | 価格 | 料金が少し高く感じます | 否定的な評価 |
| A | 使いやすさ | 画面の操作は分かりやすかった | 肯定的な評価 |
| B | 使いやすさ | メニューを探すのに迷いました | 否定的な評価 |
この例の回答数は2です。ラベルの付与件数は、価格が1件、使いやすさが2件で、合計3件になります。使いやすさの2件は、回答Aと回答Bに一つずつ付いた数です。ラベルを複数付けられる設計なので、回答数2とラベル件数3が異なることに問題はありません。「回答数3」と書いたり、ラベル件数の合計を回答者の人数として報告したりしないでください。
この数字は、ラベルを一つずつ付けた件数の合計です。同じ回答の中で同じラベルを複数回付ける方式ではなく、回答ごとに各ラベルを高々一回付ける例として示しています。実際の調査で別の数え方を採用する場合は、集計表の定義にその数え方を明記します。回答数に未回答や除外済みの行を含めるかどうかも、分類件数とは分けて説明してください。
根拠と件数を原文で確かめる
分類結果の確認では、各ラベルから回答IDへ戻り、ラベルの定義と引用した根拠が一致しているかを見ます。回答にない情報を根拠として書いていないか、否定や程度の表現を変えていないかも確認します。「少し高く感じる」を「非常に高い」と強めたり、「迷いました」を回答者の能力不足と解釈したりするのは、原文にない評価を加えることになります。ラベル付与の理由は、できるだけ原文の短い語句で示します。
次に、回答IDの重複、空欄、分類対象外の行がどう扱われたかを確かめます。回答数を数えるときは、集計対象の回答IDを一件ずつ確認します。ラベル件数は、各回答に付いたラベルを数えます。複数ラベルを許可した場合、ラベル別件数の合計が回答数を上回ることはあり得ますが、回答IDが重複していないか、同じラベルを一つの回答へ誤って二重に付けていないかは別に確認します。
出力の誤りを探すときは、回答の抜け、重複、根拠のないラベル、分類基準の取り違え、肯定・否定の逆転、保留対象の確定扱いを見ます。表の合計が合っているだけでは、個々の分類が妥当とは限りません。逆に、複数ラベルのため合計が回答数を超えていても、それだけで計算誤りとは言えません。集計の単位と複数回答のルールに照らして判断します。
| 確認項目 | 照合方法 | 注意点 |
|---|---|---|
| 回答数 | 分類対象の回答IDを数える | 回答者数やラベル件数と混同しない |
| ラベル件数 | 回答ごとの付与ラベルを数える | 複数ラベルなら回答数と一致しない場合がある |
| 根拠 | ラベルごとに原文を読み返す | 原文にない意図や程度を足さない |
| 分類基準 | 定義と境界例を確認する | 基準変更前後の回答を混ぜない |
| 除外・空欄 | 対象外の理由と件数を確認する | 集計対象から外した行を隠さない |
補足の図を開く(手順と数値は本文でも確認できます)
分類の結果を共有するときは、対象となった回答数、複数ラベルを許可したこと、ラベルの数え方、除外した行の扱いを併記します。自由記述をそのまま掲載すると回答者を特定できる場合があるため、引用の共有範囲も確認してください。必要以上に原文を広げず、個人情報や機密情報の扱いを社内ルールに合わせます。
架空データを実際に入力したAI実演
実際に入力した条件とAIの返答
2026年11月22日、OpenAIモデル(実行環境の表示名:gpt-6.1-sol)へ、議事録・見積・アンケート・月次売上・公募要領の5つの架空課題をまとめて1回送信しました。以下は、この記事の課題に対応する返答の抜粋です。実在の顧客資料や業務データは使っていません。
入力と依頼の要旨
A:料金が少し高く感じます。画面の操作は分かりやすかった。 B:メニューを探すのに迷いました。
価格=料金・費用の話、使いやすさ=操作・画面・メニューの話として複数ラベルを認める。回答IDごとのラベルと原文根拠を示し、回答数とラベル付与件数を別々に数える。書かれていない意図は推測しない。
入力と依頼は、送信内容を日本語で読みやすく整理したものです。AI返答の引用部分は、実際の応答から抜き出しています。
実際に送信した依頼文(5課題分の全文)
実際の依頼文には、この記事以外の4課題と共通の出力条件も含まれています。次の欄で全文を確認できます。
This is an actual one-shot AI demonstration, not research and not a simulated transcript. Your reply itself will be the observed model output. Do NOT fabricate tool runs, prior outputs, accuracy tests or execution dates. No tools or external services. Return only a single JSON object with the five keys meeting, quotation, survey, sales, guideline_diff. For each solve the provided task with concise Japanese structured output and explicit uncertainty; no explanatory preamble. Data below is entirely fictional, public-safe and may be quoted in articles. (1) meeting: 原文『担当Aは問い合わせフォームの項目案を次回会議までに作る。電話番号を必須にする案も出たが、決定ではない。公開日は来月以降で調整し、まだ決めない。議事録を共有する前に担当Bが原文を確認する。』 Extract rows of 状態(決定済み/提案/未決),作業,担当,期限,原文根拠. Do not infer missing people or dates. (2) quotation: 見積A『10席、1席月額12,000円・税抜、12か月、初期費用18,000円・税抜、基本保守12か月を含む』 見積B『10席、1席月額11,000円・税込、12か月、初期費用0円、保守の記載なし』. Extract comparable fields and state if a same-condition total-price winner can be determined. Do not assume tax rate or treat missing support as none/free. (3) survey: A『料金が少し高く感じます。画面の操作は分かりやすかった。』B『メニューを探すのに迷いました。』 Labels:価格=料金/費用の話、使いやすさ=操作/画面/メニューの話. Allow multiple labels. Return each ID's label and exact supporting excerpt; count answers and label assignments separately, do not infer hidden intent. (4) sales: 3月確定税抜売上100万円、所定営業日20日。4月確定税抜売上120万円、所定営業日18日、そのうち一度だけの案件30万円。 Return original monthly increase, per-business-day increase and recurring-sales increase after excluding the one-off case. Show arithmetic; distinguish definitions and do not infer actual business causes. (5) guideline_diff: 架空要領A: 制度『検証用支援』第1回、版v1 2026-11-01 p2対象者『小規模事業者』 p4対象経費『機器の購入費』 p6締切『2026年12月1日17時』。架空要領B:同制度同募集回、版v2 2026-11-20 p2対象者『小規模事業者』 p4対象経費『機器の購入費。ただし保守費は対象外』 p6締切『2026年12月8日17時』。 List unchanged/changed claims with exact before/after quotes and page; do not infer application eligibility or costs not stated. This is not a real grant. Keep all five outputs together under 5000 Japanese characters. No file writes or CMS actions.AI返答の抜粋
| 回答ID | ラベルと原文根拠 |
|---|---|
| A | 価格:「料金が少し高く感じます。」/使いやすさ:「画面の操作は分かりやすかった。」 |
| B | 使いやすさ:「メニューを探すのに迷いました。」 |
回答数:2/ラベル付与総数:3/ラベル別付与数:価格1、使いやすさ2
編集側で確認したこと
入力の回答IDはAとBの2つで、Aに2ラベル、Bに1ラベルが付いています。各根拠の引用が原文にあることと、回答数2・ラベル付与総数3を別々に確認しました。この例から実際の回答全体の分類精度は分かりません。
これは架空の小さな入力に対する1回の観測です。実資料での読み取り精度、業務時間の短縮、別のAIとの優劣を測った結果ではありません。同じ入力で同じ返答になることも保証しません。
分類プロンプトと共有前の確認表
以下は分類候補を作るための指示文です。分類ラベルの定義を先に記入し、入力してよいと確認できた回答だけを使います。AIに判断が難しい回答を無理に割り当てさせず、根拠の引用と判断保留を出力に含めるようにします。
自由記述を、下記の定義に沿って分類してください。
回答ごとに、回答ID、付与ラベル、ラベルごとの根拠となる原文、判断保留の有無を出してください。
一つの回答に複数の話題がある場合は、定義に合う複数ラベルを付けてください。
書かれていない意図や理由を推測せず、根拠がないラベルは付けないでください。
判断できない場合は「判断保留」としてください。
回答数とラベル付与件数を分けて集計し、数え方を説明してください。
ラベル定義:
<ここに分類基準を記載>
回答:
<入力が許可された匿名化済み回答を記載>出力を使う前に、回答IDと元の回答の対応、各ラベルの根拠、回答数とラベル付与件数を別々に確かめます。基準を変更した場合は、変更前の結果と混ぜず、必要に応じて同じ対象へ新しい基準を適用し直します。外部AIを使う場合は入力許可を先に確かめ、承認なしに個人情報や機密情報を送らないでください。
- 分類単位と、空欄・除外の扱いを明記した。
- ラベルの意味と複数付与のルールを決めた。
- 各ラベルの根拠が原文にあり、勝手な推測を含まない。
- 回答数とラベル付与件数を分けて表示した。
- 個人情報・機密情報の入力可否と共有範囲を確認した。